Este repo y el IQL: de la metodología al código
El IQL dice qué hay que hacer en cada momento del ciclo de calidad. Este repo es una implementación concreta: qué skill ejecuta cada stage, qué artefactos deja en Jira, dónde está escrita la doctrina y con qué herramientas habla el agente.
Método e implementación
El IQL (Integrated Quality Lifecycle) es la metodología de UPEX: 15 steps agrupados en tres fases (Early-Game, Mid-Game y Late-Game) y una escalera de stages que se ejecutan y se gatean. La versión oficial está en upexgalaxy.com/metodologia.
Este repo pone esa metodología a funcionar sobre Playwright, TypeScript y Bun. Cada stage tiene una skill que lo ejecuta (salvo Observation), cada skill se detiene en checkpoints donde una persona revisa y decide, y cada artefacto queda enlazado desde la historia de usuario hasta la corrida de regresión que valida el release. El resumen del reparto: el agente ejecuta, la evidencia prueba cada conclusión y la persona toma la decisión.
Los stages y quién los ejecuta
Los stages tienen nombre y nunca número. La numeración vieja chocaba con los steps del IQL,
así que sobrevive en un solo lugar: la tabla de equivalencias de
.agents/skills/agentic-qa-core/references/stage-gates.md.
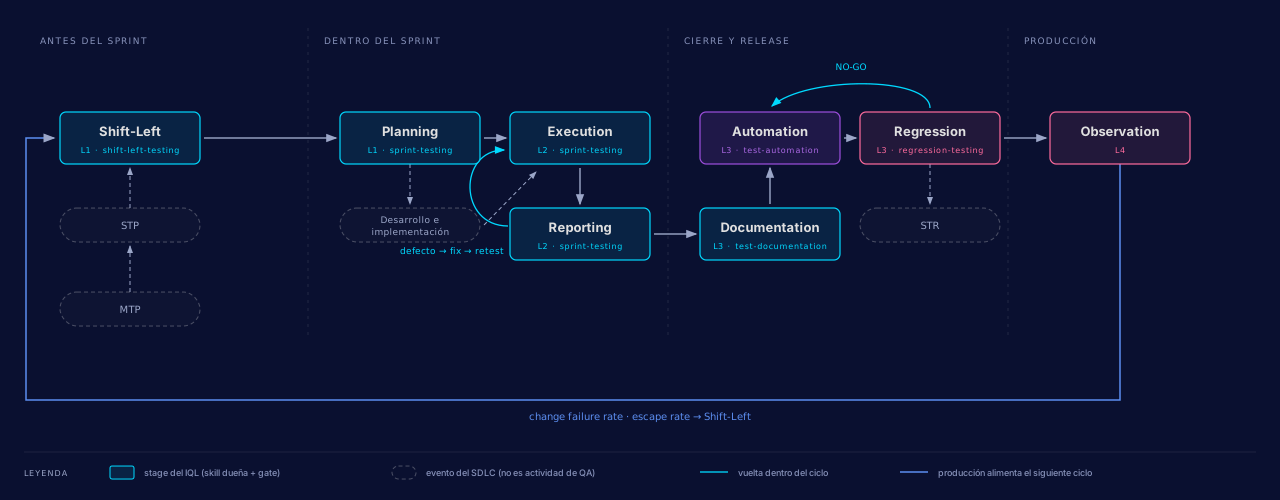
| Stage | Momento | Skill dueña | Qué deja al terminar | Autonomía (0-5) |
|---|---|---|---|---|
| Shift-Left | Pre-sprint, por lotes | shift-left-testing |
ACs reescritos, huecos convertidos en preguntas para PO y Dev, el ATP pre-sprint
escrito en el campo {{jira.acceptance_test_plan}}, las etiquetas
shift-left-reviewed y shift-left-{YYYY-MM-DD}, y la
historia movida a estimation
|
2 |
| Planning | En el sprint | sprint-testing |
ATS, ATP y ATR creados en ese orden, test cases derivados de los ACs y la decisión de qué superficies (UI, API, DB) se prueban | 2 |
| Execution | En el sprint | sprint-testing |
Smoke primero como Go/No-Go, exploración por UI, API y DB (la "trifuerza"),
evidencia en la carpeta evidence/ y bugs propuestos con su severidad
|
3 |
| Execution sin ticket | A demanda, en el sprint o después | exploratory-testing |
Charter, reconocimiento en paralelo por UI, API y DB, un pase que intenta refutar
cada hallazgo y escenarios candidatos marcados NEW, WEAK o COVERED contra la
cobertura existente, con oracle: observed hasta que una persona los
confirma
|
3 |
| Reporting | En el sprint | sprint-testing |
ATR completo, comentario de QA en la historia, links de trazabilidad verificados | 2 |
| Documentation | Post-sprint | test-documentation |
Veredicto de ROI por escenario (Candidate, Manual o Deferred); cada Candidate entra
al RTP con la etiqueta regression-candidate
|
2 |
| Automation | Post-sprint | test-automation |
spec.md y automation-plan.md aprobados, tests KATA con
@atc, verificación en contexto limpio y un PR
|
2, y 3 dentro del plan aprobado |
| Regression | Post-sprint | regression-testing |
Cada falla clasificada, pass-rate y tendencia, veredicto GO / CAUTION / NO-GO y un RTR por veredicto | 3 (4 en un GO limpio) |
| Observation | Producción | ninguna todavía | Declarado: señales de producción (SLO, error budget, RUM, canary) convertidas en ítems de backlog que reabren el siguiente Shift-Left | 3 (declarada) |
sprint-conductor corre Planning, Execution y Reporting con un worker de
sprint-testing por ticket y el Sprint Board como único punto de control. Cada
worker cumple los gates de su stage; el conductor suma una verificación en cada cierre:
relee el estado del ticket él mismo y revisa los artefactos, nunca solo el reporte.
Ninguna skill de .agents/skills/ lo ejecuta. Su unidad operativa sería una
rutina agéntica (una corrida recurrente o autónoma, no una skill que alguien invoca), y
por eso no tiene checklist de Definition of Done: un checklist vacío parecería un gate
implementado. Se nombra para que el ciclo no termine en Regression. El detalle está en
Observation.
Dos piezas quedan fuera de la tabla a propósito:
- Onboarding
-
Se hace una vez por proyecto.
project-discoverygenera por ingeniería inversa el mapa de dominio y el de infraestructura (dentro de sus context skills),project-contextproduce los mapas de negocio y el master test plan, ytest-framework-adaptationconecta KATA con el stack del proyecto. - Sprint close
- Es el borde del lote, no un stage. Ahí se cierran el STP y el STR del sprint, y lo hace quien llegue primero: Reporting o Regression. Tiene su propio bloque de DoD.
Cada stage tiene además un contrato agéntico: qué hace el agente, qué firma la persona, qué
evidencia tiene que sobrevivir, cuánta autonomía tiene y si hace falta un verificador
separado. Ningún stage pasa de 3 en la escala de autonomía, salvo Regression, que puede
llegar a 4 en un GO limpio (una corrida sin fallas no necesita firma; un CAUTION o un NO-GO
sí). Automation es el único con verificador obligatorio (/pr-review-lead o
/judgment-day en contexto limpio). El contrato completo está en
.agents/skills/agentic-qa-core/references/stage-gates.md.
Perfil manual y perfil agéntico
El método no cambia cuando cambia quien ejecuta. Los gates están escritos contra artefactos observables, no contra quién los produjo.
| Perfil | Quién ejecuta | Quién decide |
|---|---|---|
| Manual | Un QA, a mano | El mismo QA |
| Agéntico | Una skill bajo el modelo de orquestación | Una persona en cada checkpoint, según el contrato del stage |
En los dos perfiles son idénticos la secuencia de stages, los checklists, la escalera de artefactos, los links de trazabilidad y la vara de evidencia para GO/NO-GO. Un equipo sin IA corre el mismo ciclo. Un agente que no cumple un gate no puede saltarlo por ser agente, y una persona que lo salta se saltó el mismo gate. Lo que el perfil agéntico compra es velocidad y consistencia en el trabajo mecánico; la mitad de decidir sigue siendo humana.
El agente trabaja como centro de comando: despacha subagentes para leer, ejecutar y
verificar, y cada uno reporta antes de avanzar. Para trabajo que no cabe en un turno (una
historia completa, un módulo) existe un segundo ejecutor opcional, el worker supervisado,
coordinado por la skill orca-orchestration. Si el runtime de orquestación no
está instalado, las skills no lo mencionan y el trabajo sigue por subagentes.
La escalera de artefactos
Cada plan y cada corrida es un ítem propio de Jira con un título que dice su altura en el
primer token: {ACRONYM}: {scope}: {desc}. El ítem es la forma preferida; el
custom field de la historia queda como fallback. La excepción es el ATP pre-sprint, que vive
solo en el campo hasta que Planning crea el Test Plan a partir de él. La norma ratificada
está en .agents/skills/agentic-qa-core/references/planning-ladder.md.
| Altura | Plan | Corrida | Cuántos |
|---|---|---|---|
| Producto |
MTP Master Test Plan: la descripción del Epic
QA Master Test Plan (copia local en
.context/PBI/qa-artifacts/master-test-plan.md)
|
(no tiene) | 1 por proyecto |
| Feature | FTP Feature Test Plan | (no tiene) | 1 por feature Epic |
| Sprint | STP Sprint Test Plan |
STR Sprint Test Results, p. ej.
STR: Sprint#30: Regression Testing
|
1 por sprint |
| Historia | ATP Acceptance Test Plan |
ATR Acceptance Test Results (ATR: {STORY-KEY}: Story Testing)
|
1 por historia |
| Regresión | RTP Regression Test Plan (vive siempre, nunca se completa) | RTR Regression Test Results | 1 RTP por proyecto o módulo; 1 RTR por veredicto |
Debajo de la escalera están el ATS (Acceptance Test Set, uno por historia,
ATS: {STORY-KEY}: {story title}), cuyo link a la historia es el que da
cobertura en Xray, y los TC (issues de tipo Test). Un Test Set a nivel
feature (TS:) es opcional.
Cada artefacto tiene un solo hogar, definido en tres ejes:
parent        ->  Epic de proceso QA   (qué balde lo registra)
issue link    ->  alcance probado      (historia, feature Epic o sprint)
components -> módulo del producto (qué parte del producto toca)| Epic de proceso QA | Qué cuelga de él |
|---|---|
QA Master Test Plan |
Todos los Test Plan: FTP, STP, ATP, RTP |
QA Test Repository |
Todos los Test (test cases) |
QA Test Artifacts |
Test Executions (STR, ATR, RTR), Preconditions y Test Sets (ATS, TS) |
QA Defect Management |
Bugs, Defects e Improvements |
Nunca se cuelga un artefacto de QA de un Epic de producto. La relación con la historia va por issue link.
Ciclo de vida de cada artefacto
Crear un artefacto no alcanza. Un ATP congelado en Planning o un ATR en
ACTIVE después de que el stage cerró le dicen al equipo que el trabajo no se
hizo. Por eso cada stage es dueño del estado de lo que creó, y
.agents/skills/agentic-qa-core/references/artifact-lifecycle.md define para
cada artefacto dónde nace, quién lo mueve y dónde termina. Otras reglas del mismo archivo:
-
El
assigneese pone en el momento de crear. Xray rechaza editar la membresía de un Test Plan que no es tuyo. -
Si un slug de transición no existe en el proyecto, el agente lista las transiciones
reales, te propone la más parecida en una sola pregunta y recomienda
bun run jira:sync-workflows. Nunca adivina un id ni se salta el paso en silencio. - Cada stage cierra con el verificador liviano: artefactos, links, estados, assignee, parent y components, campos escritos, checkpoint de progreso y footer de sesión, cada línea con un SÍ o un N/A explícito.
El quality gate: GO / CAUTION / NO-GO
El veredicto de release lo emite regression-testing con un puntaje ponderado a
partir de cuatro factores: pass rate, regresiones, tests críticos y tests flaky. La tabla de
puntos, los umbrales de cada veredicto y los vetos viven en su SKILL.md
(fase Report & Decide); esta página no los copia para que no queden viejos.
| Veredicto | Qué pasa |
|---|---|
| GO | Release aprobado |
| CAUTION | Revisión manual y riesgos aceptados documentados; la persona decide |
| NO-GO | Release bloqueado: se arreglan las regresiones y se vuelve a correr |
Hay vetos que ignoran el puntaje: nunca hay GO automático si falla un test
@critical, si existe una regresión de severidad alta o crítica, o si el pass
rate queda por debajo del mínimo que fija el skill. Cada falla cae en una sola de las clases
que define el skill (KNOWN se parte en KNOWN-BLOCKED y KNOWN ISSUE; ver
Late-Game), y la palabra FLAKY solo se permite
con al menos cinco corridas de historial.
Dónde vive la doctrina
El modelo de trabajo no se improvisa por sesión. Está escrito en pocos lugares y las skills lo citan en vez de copiarlo.
AGENTS.md-
La memoria del agente, en capas.
AGENTS.mdcarga en cada sesión: la frase obligatoria de cada regla crítica (§1), la capa de comportamiento entera (§2, espejo humano en Personalidad de la IA), el núcleo del modo de orquestación (§3) y un router. El router nombra las secciones de.agents/instructions/que se leen a pedido: mapa de qué cargar por tarea (§4), registro de skills y MCPs (§5), resolución de herramientas (§6) y el resto. .agents/skills/REGISTRY.md- Las reglas compactas de cada skill, que se inyectan en la sección "Project Standards" de cada briefing a un subagente.
## Subagent Dispatch Strategy- Una sección dentro de cada skill de workflow que dice qué pasos se delegan y con qué patrón (Single, Sequential, Parallel, Background).
.agents/skills/agentic-qa-core/references/-
La biblioteca compartida de doctrina: un archivo por tema, y cada uno abre diciendo qué
regla lo cita. La lista es la de la carpeta (
ls). iql-context-
La skill que le da al agente el índice de esta metodología: por qué el proceso tiene los
stages que tiene, qué es cada artefacto de la escalera, dónde se hace cumplir cada
invariante. Es conocimiento puro, nunca ejecuta un stage, y se carga sola cuando preguntas
"por qué se hace así?". Cada proyecto la adapta en dos lugares:
qa.methodologyen.agents/project.yaml(qué stages corre y con qué rigor) y.agents/skills/iql-context/references/project-overrides.md(sus reglas y excepciones propias).
Skills
Una skill es una capacidad del agente guardada en .agents/skills/ (compartida
por Claude Code, OpenCode y Codex). Se activa cuando lo que pides coincide con su
descripción, o la invocas por nombre. Las de la comunidad las instala
cli/install.ts a nivel de proyecto y no están versionadas en el repo. El
catálogo es .agents/skills/REGISTRY.md (generado por
bun run skills:registry).
.agents/instructions/agent-skills-and-mcps.md es el router de frases
disparadoras que el agente usa para elegir skill, no el inventario.
Comandos
No hay archivos de comando: una skill se invoca por su nombre más un modo. En Claude Code es
/project-context test-plan; en OpenCode y Codex nombras la skill y el modo en
prosa. El primer token de tus argumentos que coincide con un modo es el modo y el resto se
le pasa a la skill; si ninguno coincide, la skill pregunta. Los modos de cada skill están en
su SKILL.md.
Integraciones
Las skills nunca nombran una herramienta concreta. Escriben una etiqueta como
[DB_TOOL] y la tabla de resolución de
.agents/instructions/agent-tool-resolution.md decide qué herramienta es. Si
cambias la fila, cambias el backend sin tocar ninguna skill. La regla general: primero la
CLI (gasta menos tokens) y el MCP como fallback.
| Etiqueta | Dominio | Principal | Fallback |
|---|---|---|---|
[ISSUE_TRACKER_TOOL] |
Jira: historias, bugs, epics | /acli |
MCP de Atlassian (opcional, ver mcp-atlassian-optin.md) |
[AUTOMATION_TOOL] |
Navegador | /playwright-cli |
Ninguno: es el único camino, no hay MCP de navegador |
Dos filas de ejemplo; la tabla completa, con todas las etiquetas, es la de
.agents/instructions/agent-tool-resolution.md. La modalidad del TMS se decide
una vez por proyecto. En las dos, ATP y ATR son ítems Test Plan y Test Execution: de Xray en
jira-xray, work types nativos de Jira en jira-native (sin
Xray). Solo cuando ese work type falta en una instancia jira-native se usan el custom field
de la historia y, sin campo, un comentario. Los test cases son issues de tipo Test. Las
guías de conexión están en Jira y Xray,
DBHub, OpenAPI y
Postman.
MCPs
Un MCP (Model Context Protocol) es un puente entre el agente y un sistema vivo. El conjunto
canónico es lo que declara .mcp.json (Claude Code). El mismo conjunto existe en
opencode.jsonc y en .codex/config.toml, cada uno en su formato, y
bun run agents:compat:check falla si un server aparece en un host y no en otro.
Solo viven ahí los servers locales que leen valores del proyecto y los que no necesitan
clave; los remotos cuyo único contenido era una API key (búsqueda web, Postman) se conectan
a nivel del harness y los skills los resuelven por capacidad (cómo).
Qué hace cada server y cuándo se usa está en la tabla de MCPs de
.agents/instructions/agent-skills-and-mcps.md; las variables que necesita cada
uno las lista bun run setup:doctor.
El árbol .context/PBI/
.context/PBI/ es una caché local de Jira, ignorada por git. La genera
scripts/sync-jira-issues.ts y la reconstruyes entera con
bun run context:hydrate. Jira es la fuente de verdad: los archivos
sincronizados nunca se escriben a mano. Se regenera en cada sync, así que versionarla solo
produciría conflictos entre sesiones que sincronizaron en momentos distintos. Un módulo es
un Epic (1:1).
| Tier | Fuente de verdad | En git? | Cómo se recupera |
|---|---|---|---|
| SYNC | Jira | No | bun run context:hydrate |
| COMMIT | Este repo | Sí | git |
| LOCAL | Nada durable | No | No se recupera: es descartable |
El árbol completo, con el tier de cada ruta, está en
.context/PBI/README.md (versionado) y en
.agents/instructions/agent-local-context-pbi.md.
Tres reglas para trabajar con esta caché:
-
Para leer el detalle de un issue (custom fields, ACs, ATP, ATR, comentarios) usa
bun run jira:sync-issues get <KEY> --include-commentsy lee el.mdgenerado.acli viewdevuelve null en los custom fields. -
Cada Test aparece una sola vez, bajo la historia que cubre. Uno sin camino a ninguna
historia cae en
epics/_orphans/tests/, que funciona como lista de pendientes de trazabilidad. -
Un archivo
[LOCAL]existe solo en la máquina que lo creó. Si otra máquina necesita ese contenido, va a Jira.
Fuera de PBI/, .context/ guarda solo los archivos de los que el
repo es la fuente de verdad: las decisiones de arquitectura de tests en
.context/ADR/ y project-config.md. Todo lo demás se ignora por
defecto (la lista la tiene .gitignore). El Master Test Plan no: vive en Jira y
su copia está en PBI/qa-artifacts/master-test-plan.md. El estado de sesión va
en .session/, para que un re-sync no lo pise. Para ver qué está cubierto sin
llamar a Jira, bun run tests:map genera un mapa de cobertura en HTML. Los mapas
(dominio y glosario, infraestructura, datos, API, recorridos E2E) no están en
.context/: son una síntesis, así que viven dentro de sus context skills como
HTML. Los abres en bun run docs (carpeta Mapas de contexto); la IA los lee con
bun run context:map.